

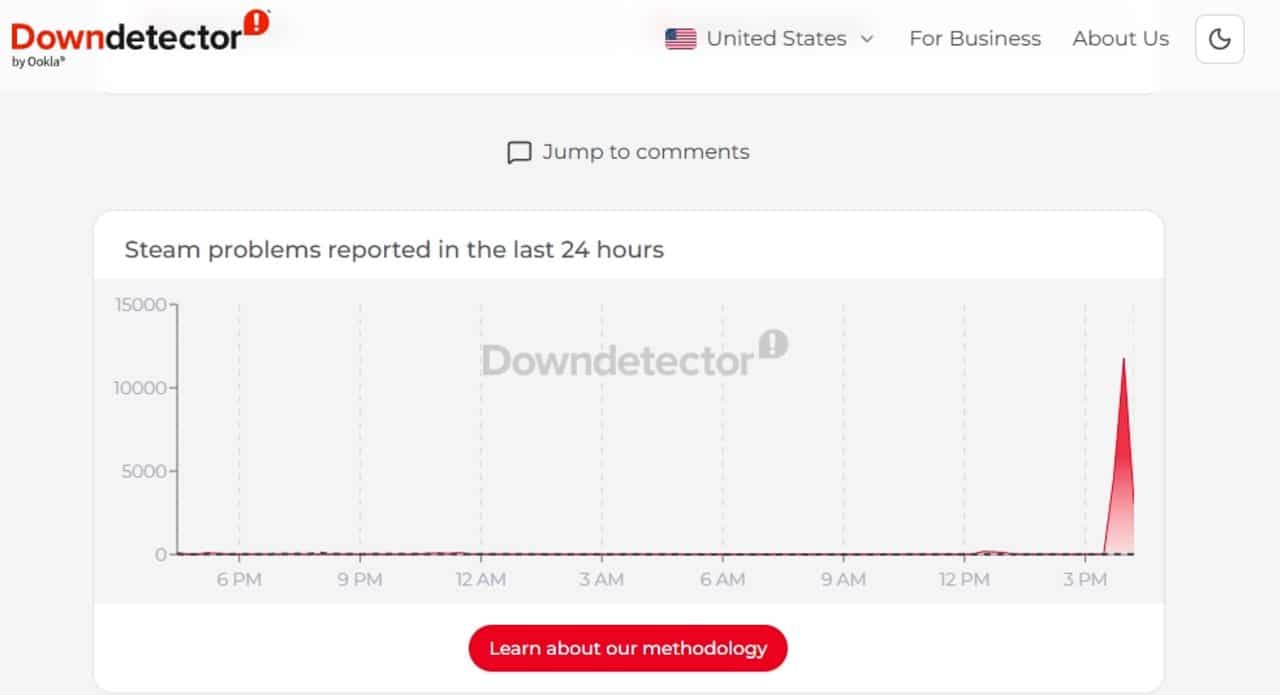
2月20日午後、コンテンツ配信システムの深刻な障害がインターネットインフラを襲い、世界規模でSteamプラットフォームへのアクセスがブロックされた。この事件はオースティン時間の午後 1 時 38 分頃に始まり、ゲーム ライブラリやオンライン サービスにアクセスできないユーザーからの大量の苦情が寄せられました。この問題は、大規模ポータルの運用とセキュリティに不可欠なネットワークである Cloudflare サーバーの障害が原因であることが判明し、連鎖反応を引き起こし、数百万人の接続に影響を及ぼしました。
リアルタイムの監視データは、サービス停止の追跡に特化した Web サイトで、わずか 1 時間の間にピーク時の 431,000 ページビューを記録し、この出来事の規模を浮き彫りにしました。この障害は特定の地域に限定されず、すぐに複数の大陸に広がり、デジタル エンターテインメント サービスがコンテンツ配信ネットワーク (CDN) および分散 DNS システムに大きく依存していることが明らかになりました。
Cloudflareは、インフラストラクチャに接続エラーが存在することを公的に認め、不安定性の原因を特定するために行動しました。技術者は、1.1.1.1 サービスのホームページでエラー率が大幅に増加していること、およびボット管理と Workers AI サービスの複雑さを観察しました。特定されたもう 1 つの重要な点は、ニューアーク データ センター (EWR) によって処理される HTTP リクエストの待ち時間が長いことであり、これがエンド ユーザーが感じる遅さとアクセス不能の決定的な原因となっていました。
技術的中断診断
現代のインターネットのアーキテクチャは、オリジンサーバーとユーザーの間の重要な仲介者として機能する Cloudflare のようなサービスに依存しており、DDoS 攻撃に対する保護とトラフィックの最適化を提供します。この中間層に障害が発生すると、たとえゲーム会社のサーバーが正常に動作していても、最終的なサービスへのアクセスが遮断されてしまいます。この相互依存の複雑さは、ネットワークの特定のノードにある問題がカスケード効果を生成したときに明らかになりました。
このインシデント中に収集された統計によると、ユーザーが直面した問題のほとんど (約 46%) はサーバーへの直接接続に関連していました。ドメイン ネーム システム (DNS) の問題は発生件数の 29% を占め、アプリケーション プログラミング インターフェイス (API) の問題は 18% に相当しました。これらの数字は、この障害がネットワーク運用の複数の柱に影響を及ぼし、アドレス解決と効果的なデータ配信の両方を損なったことを示しています。
Cloudflareのインフラストラクチャは高い冗長性を実現するように設計されていますが、さまざまなサービスベクトル間でエラーが同時発生するため、トラフィックを自動的に再ルーティングすることが困難でした。レイテンシー、つまりユーザーのリクエストとサーバーの応答の間の応答時間は、オンライン ゲームやプラットフォームのストアでのデジタル トランザクションに不可欠なリアルタイム データ通信を不可能にするレベルまで上昇しました。
システムステータスの相違
不安定な期間中、プレイヤーの認識と Steam からの公式ステータス報告の間には顕著な差異がありました。何百万人ものユーザーがログインできず、ゲームを購入できなかった一方で、Valve の監視ダッシュボードは、Steam ストア、コミュニティ、Web API が正常に動作していることを示しました。この状況は、プラットフォームの内部システムは機能している可能性がありますが、ユーザーをそこに連れて行く「道」、つまりコンテンツ配信ネットワークがブロックされているために発生します。
ただし、すべてのサブシステムが無傷で出現したわけではありません。 Counter-Strike プレイヤーのインベントリに大幅な遅延が発生し、仮想アイテムの表示と管理ができなくなりました。この種の障害はゲームの経済性とユーザー エクスペリエンスに直接影響し、トランザクションがブロックされ、試合中のスキンや装備の使用が妨げられるため、タクティカル シューター コミュニティ内で特定の苦情が発生しました。
プレーヤーを適切なサーバーに誘導する役割を担う接続マネージャー (CM) の可用性率は 93.7% でした。同時ユーザー数百万人の規模では、この数字は高いように思えますが、残りの 6.3% は、数十万人の接続を切断する可能性のある障害を表します。これらの残りのノードの過負荷は、Cloudflare 経由でルーティングできないことと相まって、消費者が経験する「ブラックアウト」シナリオを生み出しました。
国際情勢の監視
断層の地理的分布により、不均一なシナリオが明らかになりました。ヨーロッパでは、アムステルダムやロンドンなどの都市は接続マネージャーを安定した状態に保つことができましたが、フランクフルト、ストックホルム、ウィーンは「高負荷」を報告し、ネットワーク障害を補おうとしてサーバーが最大限の能力で動作していることを示しました。ヘルシンキは、一般的な接続ではデータが利用できないものの、特定の Counter-Strike サービスでは安定性があり、さまざまな状況を示しました。
アメリカ大陸では、インフラストラクチャーが相対的に優れた回復力を示しました。アトランタ、シカゴ、ダラス、ロサンゼルス、シアトルを含む米国の大規模データセンターは、低負荷または通常負荷での運用を維持しました。南米では、サンパウロ、ブエノスアイレス、リマ、サンティアゴの接続ポイントも運用状況を記録しており、これらの地域のトラフィックが代替パスを介してルーティングされていた可能性や、特定の時点でローカルノードでのCloudflare障害の発生率が低かったことを示唆しています。
一方、アジアはかなりの困難に直面した。香港は「過負荷」に分類され、危機中に需要が利用可能な処理能力を上回ったことを示した。ドバイとシンガポールも高負荷を報告した。中国では、北京や広東省などの重要なセンターで接続マネージャーのデータが利用できないことが示され、世界最大のプレーヤーベースの1つへのアクセスが深刻に中断されていることが示されました。
流通ネットワークの脆弱性
2 月 20 日の事件は、別のインターネット インフラストラクチャ大手であるアカマイの不安定性に関する報告と同時に発生しました。同社は、Cloudflare の停止との直接的な関連性は確認されていないものの、証明書プロビジョニング システムで繰り返し障害が発生していると報告しました。世界最大の CDN プロバイダー 2 社で同時に問題が発生したことにより、世界規模のコンピューター ネットワークのシステム全体の脆弱性について警鐘が鳴らされています。
最終消費者にとって、契約したサービスが使用できないことを考えると、どのプロバイダーが失敗しているかの区別は無関係です。不満がフォーラムやソーシャルメディアを席巻し、選手たちは競技試合が突然中断されたり、ゲームの進行が失われたりしたと報告した。現代のゲームの「常時オンライン」という性質により、このような停止はプラットフォームの評判に特に悪影響を及ぼします。
ネットワーク エンジニアリング チームは、インシデントの再現を防ぐためにシステムの安定性を監視し続けています。障害後の分析は、冗長性がどのようにして初期の影響を軽減できなかったのか、また、DNS または CDN サービスの障害によって将来的にグローバル エンターテイメント プラットフォームへのアクセスが完全に麻痺しないようにするにはどのような対策を講じることができるのかを理解するために非常に重要です。





