

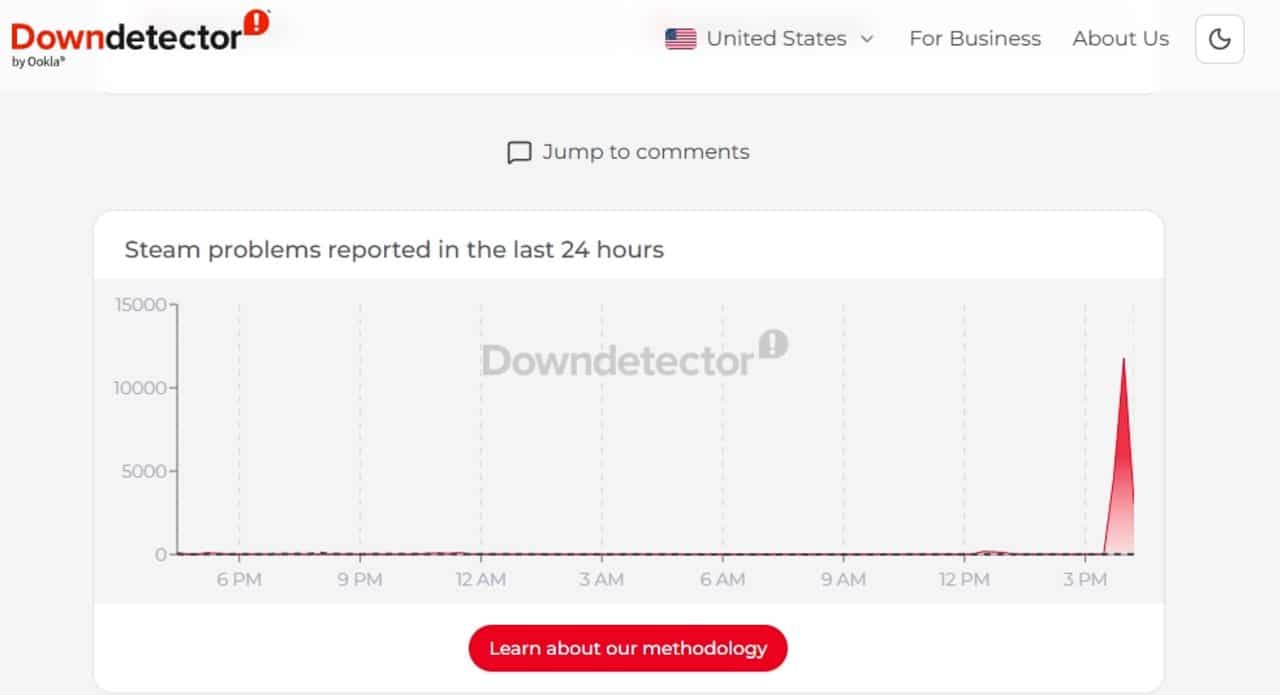
2 月 20 日下午,来自全球不同地区的玩家在访问自己喜爱的游戏时面临着难以克服的障碍。该事件于美国奥斯汀时间下午1点38分左右开始,并迅速升级为大规模断网事件。技术故障并非源于游戏平台的服务器,而是源于 Cloudflare 基础设施,这是互联网数据流量的重要网络。
投诉量在几分钟内飙升,凸显了游戏社区形势的严重性。一家专门监控在线服务的网站在短短一小时内页面浏览量就飙升至 431,000 次,令人印象深刻。这些统计数据可以作为问题严重程度的温度计,影响从初始登录到游戏内交易的一切。
服务中断凸显了大型技术提供商之间互连的脆弱性。虽然负责该平台的 Valve 公司保持其内部系统的运行,但通往这些系统的“路径”却被封锁了。对内容交付网络 (CDN) 的依赖意味着外部故障可能会导致全球运营立即停止。
初步报告表明,大部分困难集中在与服务器的通信上。大约 46% 的错误通知涉及直接连接,29% 指出域名系统 (DNS) 中的缺陷,18% 指出应用程序编程接口 (API) 中的缺陷。这些数字描绘了数据分布中的结构崩溃。
不稳定的技术诊断
Cloudflare 迅速采取行动,找出网络中断的原因。该公司确认存在影响多项服务的连接问题,包括 one.one.one.one 门户和机器人管理。 HTTP 请求的延迟急剧上升,尤其是在位于纽瓦克的数据中心,造成了阻碍信息正常流动的数字瓶颈。
技术影响超出了简单的导航范围,影响了公司的人工智能工具。 Workers AI 服务的错误率很高,这使得依赖该基础设施的开发人员和平台的情况进一步复杂化。内容分发系统的复杂性导致了问题的级联。
专家指出,现代互联网的架构虽然稳健,但也存在关键故障点。当像 Cloudflare 这样的巨头面临困难时,多米诺骨牌效应是不可避免的,导致理论上没有内部缺陷的服务瘫痪。解决这些事件需要精确的协调来恢复数据路由而不会使系统过载。
对平台资源的影响
Valve平台的用户体验在不稳定期间严重下降。尽管商店和社区在官方状态板上显示为正常运营,但最终消费者面临的现实是完全封锁。出现这种差异是因为服务器的内部状态并不反映用户通过万维网访问它的能力。
最关键的一点是《反恐精英》等热门游戏的库存延迟。处理虚拟物品的速度缓慢会拖慢游戏的经济速度,阻碍交换和购买,从而立即产生挫败感。即使连接管理器以 93.7% 的可用性运行,剩余的部分加上外部故障,也足以造成数百万人的功能中断。
停电的地理范围
断层的地理分布呈现出不规则的模式,以不同的方式影响大陆,并暴露了全球基础设施的复杂性。在欧洲,虽然阿姆斯特丹和伦敦等城市的连接管理器保持稳定,但法兰克福和维也纳的负载却很高,这表明服务器上存在局部压力。亚洲遭受了相当大的影响,香港被列为超载,中国的主要枢纽显示出不确定的连接数据,表明数百万玩家无法访问。在美洲,情况相对温和,圣保罗和几个北美城市报告状态正常,尽管由于在线游戏的相互关联性,失败的感觉是全球性的。
网络基础设施环境
Cloudflare事件并不是当天互联网生态系统中的一个孤立事件。另一家内容交付巨头 Akamai 也在处理其证书配置系统中的缺陷。大型提供商同时出现的问题凸显了全球网络的暂时脆弱性。
不同互联网骨干网同时发生故障给快速诊断带来了挑战。对于最终用户来说,游戏平台错误和基础设施故障之间的区别是不可见的,导致人们普遍认为未提供合同服务。
玩家间反响
社交媒体上充斥着用户无法开始游戏的报道。下午正值多个地区的高峰时段,突然中断,加剧了不满情绪。论坛已成为交换服务返回信息的主要渠道。
游戏社区越来越需要更高的透明度和敏捷性来解决技术问题。竞技比赛的暂停和无法访问付费数字图书馆给消费者和平台之间的关系带来了压力。在整个事件期间,人们对官方公告的期望很高。
这一事件提醒人们数字化对一些大型基础设施节点的依赖。全球 CDN 的集中服务带来了速度和安全性优势,但也增加了大规模中断的风险。这些系统的弹性不断受到不断增长的数据量的考验。
随着服务的逐步恢复,人们的注意力转向了预防措施。相关公司必须分析错误日志以实施纠正措施,防止进一步的级联中断。连接稳定性已变得与游戏内容本身一样重要。




