
AMD Radeon RX 10800 XT 모델은 4K 초고해상도 게임에서 RTX 5090을 25% 앞선다

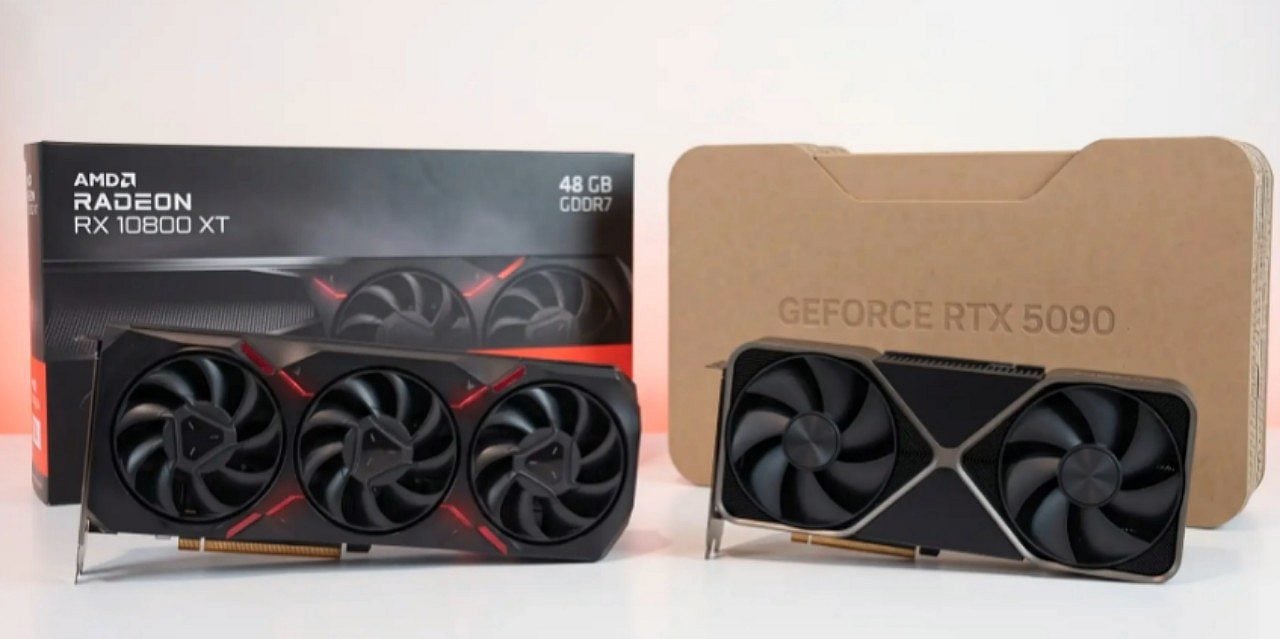
Moore’s Law is Dead와 Kepler_L2를 통해 유출된 정보에 따르면 AMD의 차세대 주력 그래픽카드인 Radeon RX 10800 XT는 RDNA 5 마이크로아키텍처를 도입하여 하드웨어 규모를 대폭 확대했다. 이번 플래그십 칩셋은 3나노미터 공정에서 제작하며 3.1 GHz에서 3.4 GHz 사이의 작동 주파수, 512비트 버스 인터페이스, 최대 48 GB의 GDDR7 메모리 및 200개에 이르는 연산 유닛을 통합했다. 제조업체는 이러한 대대적인 체질 개선을 통해 초고성능 플래그십 하드웨어 시장에서 경쟁사와의 기술적 주도권 경쟁을 본격화하고 있다.
RDNA 5 아키텍처 기반의 극대화된 하드웨어 설계
AMD Radeon RX 10800 XT의 하드웨어 규모 확장은 블랙웰 기반의 NVIDIA GeForce RTX 5090 및 차세대 루빈 아키텍처를 도입할 RTX 6090이 채택한 방식과 정반대의 구조적 노선을 보여준다. 이는 연산 블록의 총수량, 셰이더 내부 밀도, 하드웨어 가속기 배치를 종합적으로 비교 검증해야 하는 기술적 과제를 제기한다.
NVIDIA GeForce RTX 5090은 다이에 내장된 192개 물리 블록 중 활성화된 170개의 스트리밍 멀티프로세서를 갖춘 GB202 GPU를 장착했다. 블록당 128개의 CUDA 코어를 할당하여 총 21,760개의 FP32 연산 코어를 확보했으며 170개의 전용 RT 코어와 680개의 텐서 코어가 이를 지원한다. 차세대 플랫폼인 루빈 기반의 NVIDIA GeForce RTX 6090은 192개의 스트리밍 블록을 모두 활성화하여 24,576개의 CUDA 코어 체계를 구성할 예정이다. 엔비디아는 고밀도 연산 코어를 앞세워 복잡한 행렬 계산과 렌더링 파이프라인에서 독보적인 처리 속도를 유지하겠다는 전략을 취했다.
대규모 스트리밍 멀티프로세서 구성을 앞세운 엔비디아의 연산 구조
반면 AMD는 Radeon RX 10800 XT 설계에서 64개의 스트림 프로세서를 내장한 200개의 연산 유닛을 구성하여 총 12,800개의 산술 논리 유닛을 확보하는 전략을 세웠다. 경쟁 제품의 21,760개 셰이더 코어보다 절대적인 수치는 적지만, 칩렛 구조와 대용량 인피니티 캐시 및 3.1 GHz에서 3.4 GHz에 달하는 작동 속도를 결합하여 순수 FP32 처리 성능의 공백을 상쇄한다.
- 200개 연산 유닛 기반의 12,800개 스트림 프로세서 탑재
- 3.1 GHz에서 3.4 GHz에 달하는 3나노미터 공정 기반 고클럭 설계
- 512비트 버스 폭과 최대 48 GB 용량의 GDDR7 고속 메모리 채택
레이 트레이싱을 배제한 전통적인 래스터화 환경에서 고클럭으로 작동하는 200개의 연산 유닛은 라데온 그래픽 프로세서에 즉각적인 연산 우위를 제공한다. 격차는 뚜렷하다. 512비트 대역폭과 최대 48 GB 용량의 GDDR7 메모리가 결합한 RX 10800 XT는 4K 해상도 환경에서 NVIDIA GeForce RTX 5090을 15%에서 25%까지 제치는 성능을 나타낸다. 다만 루빈 기반 192개 블록의 RTX 6090은 RX 10800 XT를 15%에서 20% 앞서며 우위를 되찾지만, 전력 소모 대비 성능 효율 측면에서는 팽팽한 양상이 이어진다.
전통적인 4K 래스터화 렌더링에서 드러난 성능 역전 현상
레이 트레이싱 적용 환경에서는 RDNA 5의 광선 가속기 개선과 연산 유닛당 BVH 처리량 2배 확장에 힘입어 하이브리드 게임에서 RX 10800 XT가 RTX 5090과 대등한 성능을 구현한다. 전방위 패스 트레이싱 계산에서는 5세대 RT 코어를 탑재한 RTX 6090이 35%에서 50% 수준의 격차를 벌리지만, AMD는 텐서 코어에 필적하는 웨이브 매트릭스 유닛을 활용해 신경망 기반 FSR 프레임 생성 기술로 DLSS 품질에 근접한다.
CUDA와 OptiX API를 지원하는 전문 3D 렌더링 작업에서는 엔비디아 계열 제품군이 여전히 견고한 처리 속도를 방어한다. 반면 ROCm 및 HIP 생태계에서 512비트 대역폭과 듀얼 VCN 미디어 엔진을 결합한 AMD Radeon RX 10800 XT의 48 GB GDDR7 대용량 비디오 메모리는 RTX 5090의 32 GB 한계에서 발생하는 메모리 부족 현상 없이 8K 해상도 텍스처와 복잡한 3D 기하학 연산을 완벽하게 처리하며 언리얼 엔진 5의 나나이트 컴파일 및 Llama 3 70B 매개변수 인공지능 모델의 대규모 배치 작업을 단일 그래픽카드로 구동시킨다. 하드웨어 가용 용량의 확장은 전문 제작 환경에서 렌더링 오류를 억제하는 핵심 요소로 기능한다.
전문가용 3D 소프트웨어와 대규모 인공지능 환경에서의 메모리 우위
200개의 연산 유닛, 고주파수 동작 클럭 및 48 GB VRAM 구성을 갖춘 AMD Radeon RX 10800 XT는 전통적인 게임 구동과 비디오 편집, 로컬 인공지능 모델 운용에서 170개 멀티프로세서를 탑재한 NVIDIA GeForce RTX 5090을 상회한다. 192개 블록 구성을 준비 중인 NVIDIA GeForce RTX 6090의 루빈 아키텍처는 고부하 패스 트레이싱 렌더링과 CUDA 중심의 고밀도 연산 환경에서 최상위 성능 지표를 유지한다.




