プラットフォーム X の大規模な不安定性により、世界中で何百万人ものユーザーがアクセスできなくなります 著者 Luís Henrique Costa
読了時間 約9分
 |
プラットフォーム ロードの失敗、メッセージの公開不能、タイムラインの表示エラーなどの問題は、ブラジリア時間の午前 11 時 21 分頃から大量に報告され始め、ソーシャル ネットワークのインフラストラクチャにおける包括的かつ重大な中断を示しました。
この広範な障害はプラットフォームのモバイル アプリと Web バージョンの両方に影響を及ぼし、ユーザー ベースの大部分にとってリアルタイムのコミュニケーションが事実上不可能になりました。接続しようとするユーザーにとって、エラー メッセージと過度の速度の低下が常態化し、苦情の波と、問題がいつまで続くかについての不安が生じました。この影響は他のソーシャル ネットワークにもすぐに現れ、X の崩壊に関するハッシュタグはすぐに最も話題のトピックになりました。
Downdetector などのオンライン サービス監視プラットフォームは、問題通知の異常な急増を記録することで障害の程度を確認しました。さまざまな大陸のユーザーからの報告が突然急増したため、これは局所的な不安定性ではなく重大なイベントであるという認識が強まり、根本原因を診断して解決するには、同社のエンジニアリング チームによる迅速な対応が必要です。
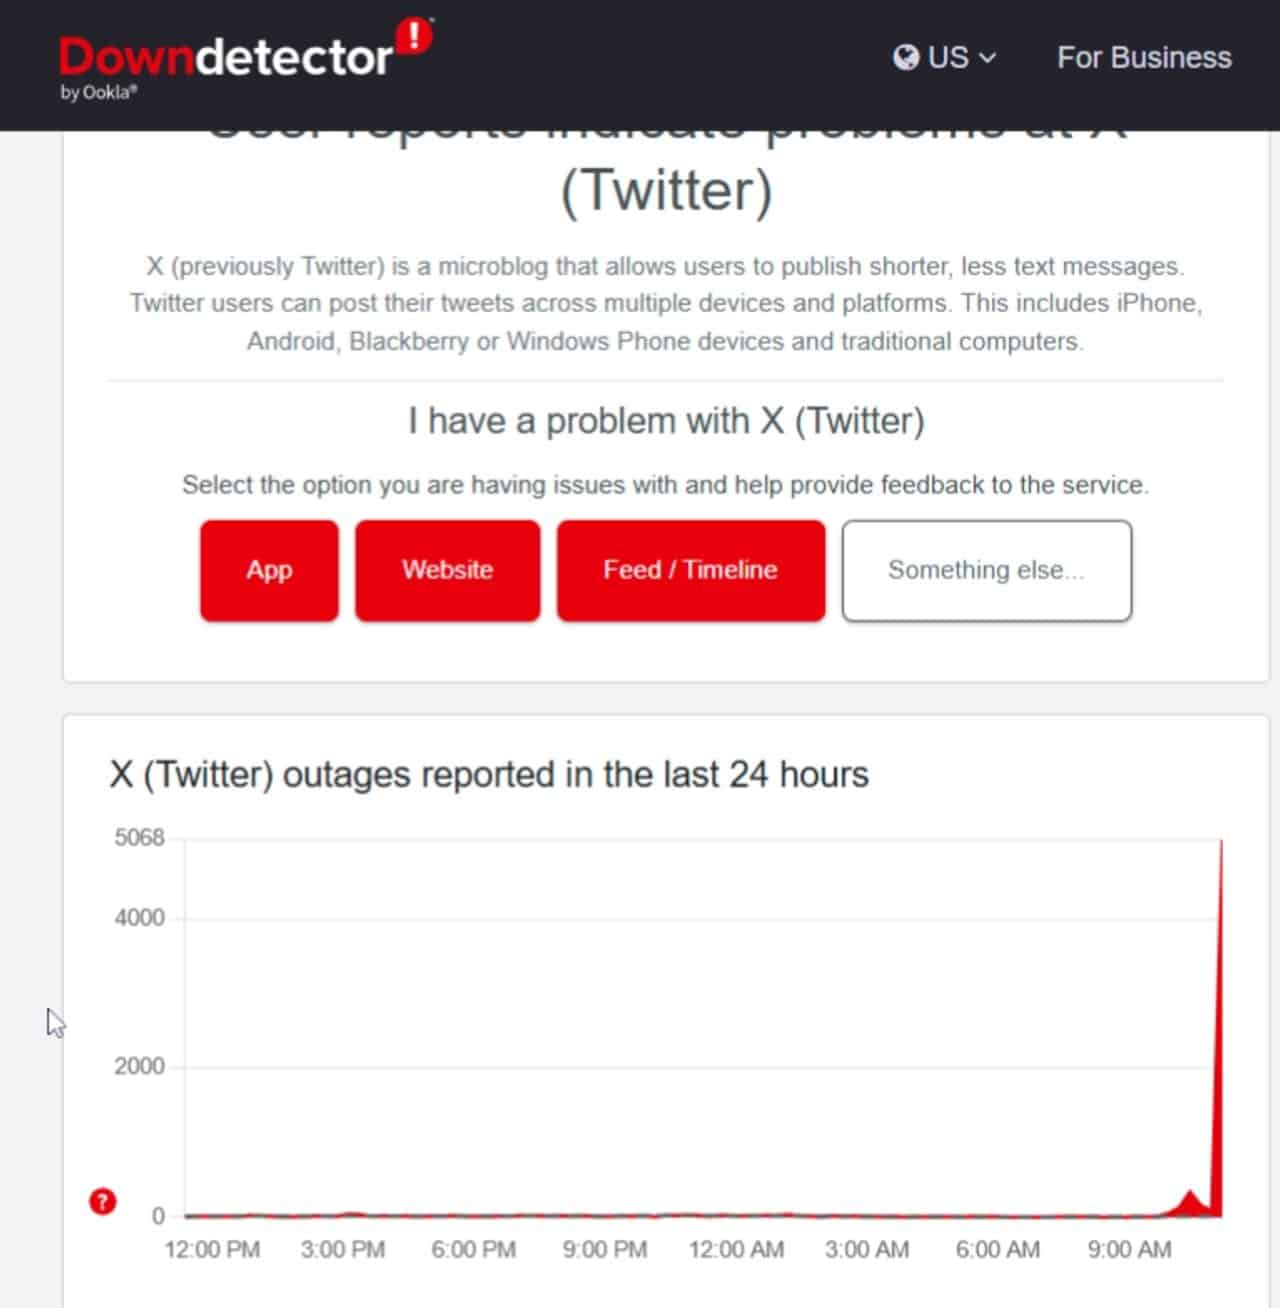
停電の詳細と最も影響を受ける地域
監視サービスによって収集されたデータにより、障害の性質が明確に把握できました。全体の 59% に相当する苦情の大部分は、モバイル アプリケーションの誤動作に集中していました。さらに 33% のユーザーが、プラットフォームの Web サイトにアクセスする際に特定の困難があると報告し、8% は、主な障害はニュース フィードの読み込みであり、アクセスできないか古いままであると指摘しました。
不安定性の地理的範囲は最も注目すべき側面の 1 つであり、北米、ヨーロッパ、アジア、南米から一貫した報告が寄せられました。異なるタイムゾーンのユーザーは、ログインしようとすると「検証」エラーが継続的に表示され、あらゆるタイプのアカウント操作が妨げられるなど、同様のエクスペリエンスを共有しました。このパターンは、障害がプラットフォームの中央システムで発生した可能性があることを示唆しています。
エラーの性質から、この機能停止は認証サーバーやコンテンツ配信システムなどの X インフラストラクチャの基本コンポーネントに関連している可能性が高いことがわかります。これらの要素に障害が発生すると、その波及効果は即座に現れ、場所やサービスへのアクセスに使用されたデバイスに関係なく、何百万もの人々のアクセスとデータ フローが同時にブロックされます。
このソーシャル ネットワークの重要なリソースの停止は、これほど大規模な作戦をサポートする技術アーキテクチャの複雑さを浮き彫りにしました。このような分散され相互接続されたシステムの復旧は、プロセスに新たな不安定性を引き起こすことなく、障害点を正確に特定し、修正を実装することを伴う重大な技術的課題を意味します。
リアルタイム通信の結果
X の中断は、一般ユーザーの不便さを超えた影響を及ぼし、プラットフォームの機敏性に依存する専門家や組織の日常業務に直接影響を与えました。ジャーナリスト、通信社、デジタル インフルエンサー、ブランドは、緊急情報を広め、一般の人々と関わるための主要なツールとしてネットワークを使用しています。閉鎖により、情報の流れを維持するために、他のソーシャル ネットワークや従来のプレス リリースなど、代替のコミュニケーション チャネルを直ちに探す必要がありました。ただし、ペースは遅くなり、到達範囲も減少する可能性がありました。
多くの企業にとって、プラットフォームはマーケティングおよび顧客サービス戦略の柱であり、活動の停止は可視性とエンゲージメントの機会の直接的な損失を意味します。この欠陥は、単一のデジタル チャネルに依存する脆弱性も明らかにします。このイベントは、オンラインでの存在感を多様化し、技術的危機のシナリオにおいて国民との継続的なコミュニケーションを確保し、評判や商業活動へのダメージを最小限に抑えるための緊急時対応計画を策定する必要性への警鐘として機能します。
故障原因の調査
現在までに、X の責任会社は、不安定性の具体的な原因を詳述する公式声明を発表していません。エンジニアリング チームはインシデントの事後分析を伝える前にサービスの復旧を優先するため、複雑な障害状況では即時に宣言が行われないことがよくあります。
テクノロジーインフラストラクチャの専門家は、この規模の障害は通常、複数の要因が組み合わさった結果発生すると指摘しています。最も考えられる原因としては、重大なバグを引き起こすソフトウェア更新の失敗、中央サーバーの過負荷の問題、世界中にデータを迅速に配信するために不可欠なコンテンツ配信ネットワーク (CDN) の構成エラーなどが挙げられます。
サイバー攻撃の可能性を完全に排除することはできませんが、ユーザーが報告するエラーの種類(アクセスと読み込みの失敗に焦点を当てたもの)は、外部からの悪意のある行為よりも内部インフラストラクチャの問題の方が特徴的です。技術チームの優先事項は、問題を切り分け、その原因となった変更をロールバックすることであり、このプロセスには数時間かかる場合があります。
ソーシャルネットワーク上での不安定性の歴史
X を襲ったような不安定なイベントは、大規模なデジタル プラットフォーム エコシステムにとって新しいことではありません。 Facebook、Instagram、WhatsAppなどの大手テクノロジー企業は過去に大規模な障害に直面しており、そのうちのいくつかは数時間続き、世界中の数十億人のユーザーに影響を与えました。こうした度重なる事件は、現代のデジタル通信を支える技術インフラの複雑さと脆弱さを常に思い出させます。社会がこれらのプラットフォームに依存するようになるにつれて、それぞれの失敗の影響がより大きくなります。これに対応して、企業は、データとサーバーのバックアップ コピーを作成する冗長システムと、できるだけ早く運用を復元するように設計された災害復旧プロトコルに多額の投資を行ってきました。しかし、ユーザーベースの継続的な成長と新しい機能の継続的な実装によりシステムの複雑さが増し、新たな潜在的な障害点が生じ、100% の稼働時間という目標が継続的な技術的課題となり、達成が困難になります。
危機時のユーザー向けガイダンス
プラットフォームはサービスを正常化するために機能しますが、専門家はユーザーが辛抱強く、過剰なログイン試行を避けることを推奨しています。リクエストの過負荷により、場合によっては、担当技術チームにとってシステム回復プロセスが困難になる可能性があります。
サービスのステータスに関する最新情報を入手するには、他のネットワークまたはニュース ポータル上の会社の公式コミュニケーション チャネルをフォローすることをお勧めします。信頼できる情報源からの情報を照合することは、不安定の原因に関する噂の拡散を防ぐのに役立ちます。
デジタルレジリエンスの継続的な探求
大規模なデジタル サービスの中断頻度により、テクノロジー業界における回復力と信頼性に関する議論が焦点になります。社会生活や職業生活がこれらのプラットフォームとますます密接になるにつれて、安定した中断のないサービスへの期待が高まり、企業にはダウンタイムを回避するためにインフラストラクチャを継続的に改善するというプレッシャーがかかっています。
緊急時戦略としての多様化
この事件は、すべてのデジタルコミュニケーションを単一のプラットフォームに集中させないことの戦略的重要性を浮き彫りにした。 1 つのサービスだけに依存すると、単一障害点が生じ、企業の運営や個人のコミュニケーション能力が完全に混乱する可能性があります。
これらのリスクを軽減するには、企業と個人ユーザーの両方が、複数のチャネルにわたってアクティブなプレゼンスを維持することを検討する必要があります。すぐに使用できる代替手段を用意しておくことで、中断時の迅速かつ効果的な移行が可能になり、通信の継続性が確保され、今回のような予期せぬ技術的出来事による悪影響が軽減されます。