
Falha global no sistema do DoorDash paralisa entregas e afeta milhares de motoristas na América do Norte


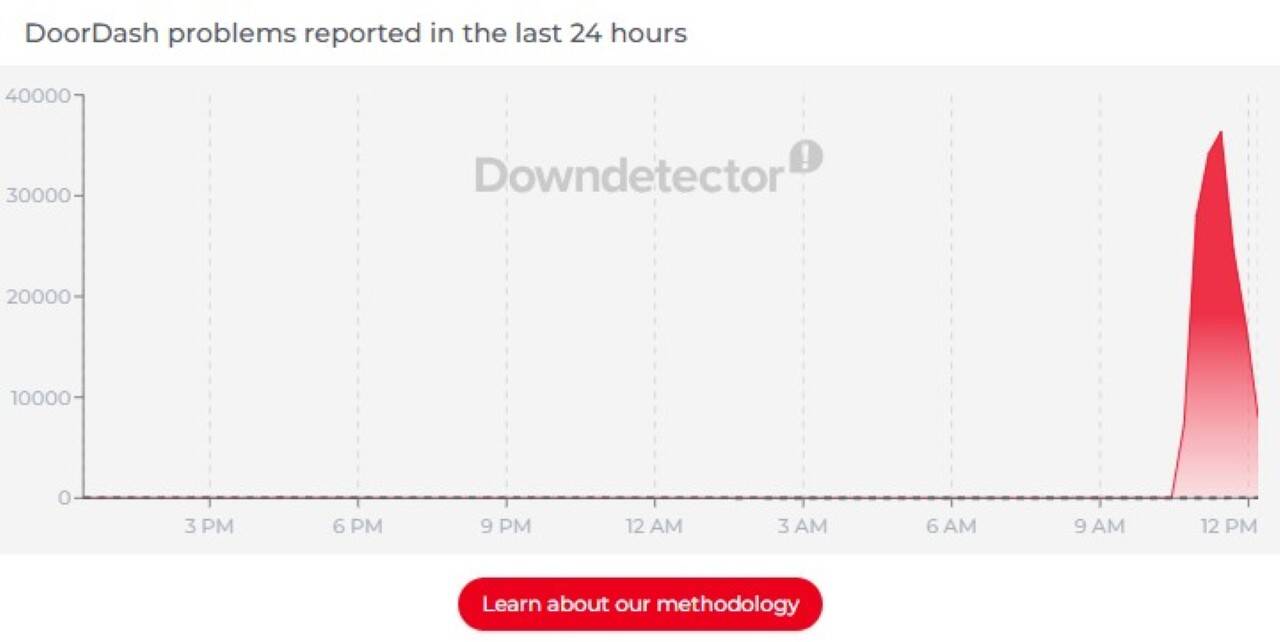
Na manhã desta terça-feira, dia 16, uma instabilidade severa atingiu os servidores de uma das maiores plataformas de delivery do mundo, interrompendo abruptamente as operações diárias de consumidores e trabalhadores. O colapso digital do aplicativo DoorDash gerou uma onda massiva de frustração, refletida em mais de trinta e cinco mil notificações de erro registradas em plataformas de monitoramento de tráfego de rede em um curtíssimo espaço de tempo. Consumidores que tentavam garantir suas refeições se depararam com telas de carregamento infinitas, enquanto a infraestrutura da empresa lutava para reestabelecer a conexão de dados.
Horário do apagão digital e os principais obstáculos enfrentados pelos consumidores
Os primeiros sinais de que a rede estava cedendo começaram a surgir exatamente às nove horas e quarenta minutos, considerando o fuso horário de Nova York, o que corresponde às dez horas e quarenta minutos pelo relógio de Brasília. A partir desse momento, a interface do software passou a exibir mensagens genéricas solicitando que as pessoas verificassem suas conexões de internet, mascarando uma falha interna profunda nos bancos de dados da companhia. A navegação pelos cardápios virtuais tornou-se impossível, bloqueando completamente a jornada de compra de quem buscava conveniência durante o horário comercial.
Um agravante significativo dessa paralisação envolveu o sistema de processamento financeiro integrado à plataforma de entregas. Diversos clientes relataram que, ao tentarem finalizar a transação, o valor da refeição foi imediatamente descontado de seus cartões de crédito ou carteiras digitais, mesmo sem a geração do número de acompanhamento do pedido. Essa desconexão entre o gateway de pagamento e o sistema de roteamento logístico cria um cenário de extrema ansiedade, exigindo que os usuários monitorem seus extratos bancários em busca de estornos automáticos que podem demorar a processar devido ao volume de erros simultâneos.
Impacto direto na renda e na rotina dos parceiros de logística da plataforma
A interrupção do serviço não causou transtornos apenas para quem aguardava o almoço, mas atingiu em cheio a espinha dorsal da operação: os entregadores independentes, conhecidos no ecossistema da empresa como Dashers. Sem aviso prévio, milhares de motoristas e ciclistas foram sumariamente deslogados de seus perfis de trabalho, perdendo instantaneamente o acesso às rotas que já estavam em andamento. Para esses profissionais, cujos ganhos dependem exclusivamente do tempo em que o aplicativo permanece funcional, cada minuto de inatividade representa um prejuízo financeiro irrecuperável em um dia de trabalho normal.
Situações de extrema confusão logística foram relatadas nas ruas das principais metrópoles norte-americanas durante o pico da instabilidade. Profissionais que já haviam retirado os pacotes nos restaurantes ficaram com os veículos carregados de alimentos perecíveis, totalmente impossibilitados de visualizar o endereço de destino final. Sem o suporte do sistema de geolocalização do aplicativo, a entrega torna-se inviável, forçando os trabalhadores a descartarem os produtos ou aguardarem horas por uma orientação do suporte técnico que também se encontrava inoperante.
Extensão territorial do problema e o comportamento dos mercados afetados
O mapeamento da falha revelou uma abrangência continental, afetando simultaneamente grandes centros urbanos nos Estados Unidos e em províncias do Canadá, além de respingar em outros territórios de atuação internacional da marca. Ferramentas independentes de análise de estabilidade, como o Downdetector, mostraram um gráfico vertical de reclamações, evidenciando que a queda não foi um evento isolado em um servidor regional, mas sim um colapso na arquitetura central do sistema. A sincronia das falhas sugere um problema em atualizações de software ou nos serviços de hospedagem em nuvem utilizados pela companhia de tecnologia.
Curiosamente, a recuperação da rede apresentou um comportamento assimétrico entre os países vizinhos ao longo do dia. Enquanto os usuários canadenses começaram a notar um retorno gradual das funcionalidades básicas ainda no final da manhã, permitindo a conclusão de algumas entregas pendentes, o cenário nos Estados Unidos permaneceu caótico por um período mais prolongado. Essa reativação fragmentada é comum em incidentes de grande escala, onde os engenheiros de software precisam reiniciar os servidores em lotes para evitar uma nova sobrecarga imediata no banco de dados principal.
Procedimentos adotados para pedidos retidos e a política de ressarcimento
O vácuo de informações deixou milhares de consumidores em um estado de incerteza em relação às compras que já haviam sido processadas antes do apagão geral. O departamento de atendimento ao cliente da empresa foi rapidamente inundado por mensagens e ligações, resultando em filas de espera virtuais intermináveis e respostas automatizadas que pouco resolviam a angústia dos clientes. O protocolo padrão da companhia para essas situações envolve o cancelamento compulsório das rotas travadas e a devolução integral dos valores, porém o volume atípico de transações interrompidas fatalmente atrasará o cronograma de reembolsos.
Para entender a complexidade da resolução de pendências financeiras em quedas de servidores, é necessário observar os diferentes cenários que se formam durante a instabilidade sistêmica:
- Pedidos que já estavam em trânsito com o motorista logado offline, que geralmente chegam ao destino, mas não podem ser marcados como concluídos no sistema central.
- Compras aceitas pelo restaurante, mas que nunca foram atribuídas a um entregador, resultando em desperdício de comida e necessidade de estorno imediato ao cliente.
- Transações onde o cartão de crédito autorizou a cobrança, mas o banco de dados do aplicativo não gerou a ordem de preparo, exigindo uma conciliação bancária posterior.
Posicionamento corporativo e a migração temporária para plataformas concorrentes
A comunicação oficial da corporação diante da crise foi considerada minimalista por especialistas em gerenciamento de risco tecnológico. Através de um breve alerta disparado internamente na própria interface do software, a administração limitou-se a reconhecer a existência da falha técnica, garantindo que suas equipes de engenharia estavam mobilizadas para solucionar o gargalo o mais rápido possível. A ausência de um diagnóstico claro sobre as causas do incidente e a falta de uma previsão exata para a normalização total dos serviços alimentaram especulações nas redes sociais e aumentaram a insatisfação geral.
Eventos de inatividade prolongada em horários de pico comercial geram um efeito cascata imediato no mercado de entregas sob demanda. Diante da impossibilidade de utilizar o serviço de sua preferência, uma parcela massiva de consumidores transferiu rapidamente sua intenção de compra para aplicativos rivais, impulsionando repentinamente o volume de acessos em plataformas como o Uber Eats e serviços de logística locais. Essa migração forçada demonstra a volatilidade da fidelidade do cliente no setor de conveniência digital, onde a disponibilidade imediata do serviço supera largamente o apego a uma marca específica.
Especialistas em tecnologia da informação recomendam que, durante apagões dessa magnitude, os usuários evitem realizar sucessivas tentativas de login ou de processamento de pagamentos, pois isso apenas contribui para o congestionamento dos servidores que já estão operando no limite de sua capacidade. A melhor estratégia é acompanhar os painéis de status de terceiros e aguardar um comunicado definitivo nos canais oficiais da empresa antes de confiar novamente dados financeiros à plataforma recém-restaurada, garantindo assim a segurança das transações e evitando cobranças duplicadas indesejadas.



