W poniedziałek, 31 sierpnia 2026 r., początek tygodnia pracy upłynął pod znakiem poważnej przerwy w dostępie do usług cyfrowych dla tysięcy profesjonalistów na całym świecie. Użytkownicy usługi e-mail technologicznego giganta zgłosili masową awarię, która uniemożliwiła im dostęp do skrzynek odbiorczych i wysyłanie wiadomości. Niestabilność osiągnęła swój szczyt późnym rankiem, zamieniając rutynę biur i pracowników zdalnych w prawdziwą przeszkodę komunikacyjną.
Niezależne platformy monitorowania sieci odnotowały wzrost liczby skarg, który trwał godzinami. Podczas gdy internauci zasypywali fora i sieci społecznościowe zrzutami ekranu pokazującymi błędy połączenia, oficjalna komunikacja firmy była powolna, aby odzwierciedlić powagę sytuacji. Ta rozbieżność między rzeczywistym doświadczeniem konsumenta a pulpitami nawigacyjnymi statusu firmy doprowadziła do dodatkowej frustracji wśród administratorów systemów informatycznych.
Ewolucja awarii i monitorowanie zawalenia w czasie rzeczywistym
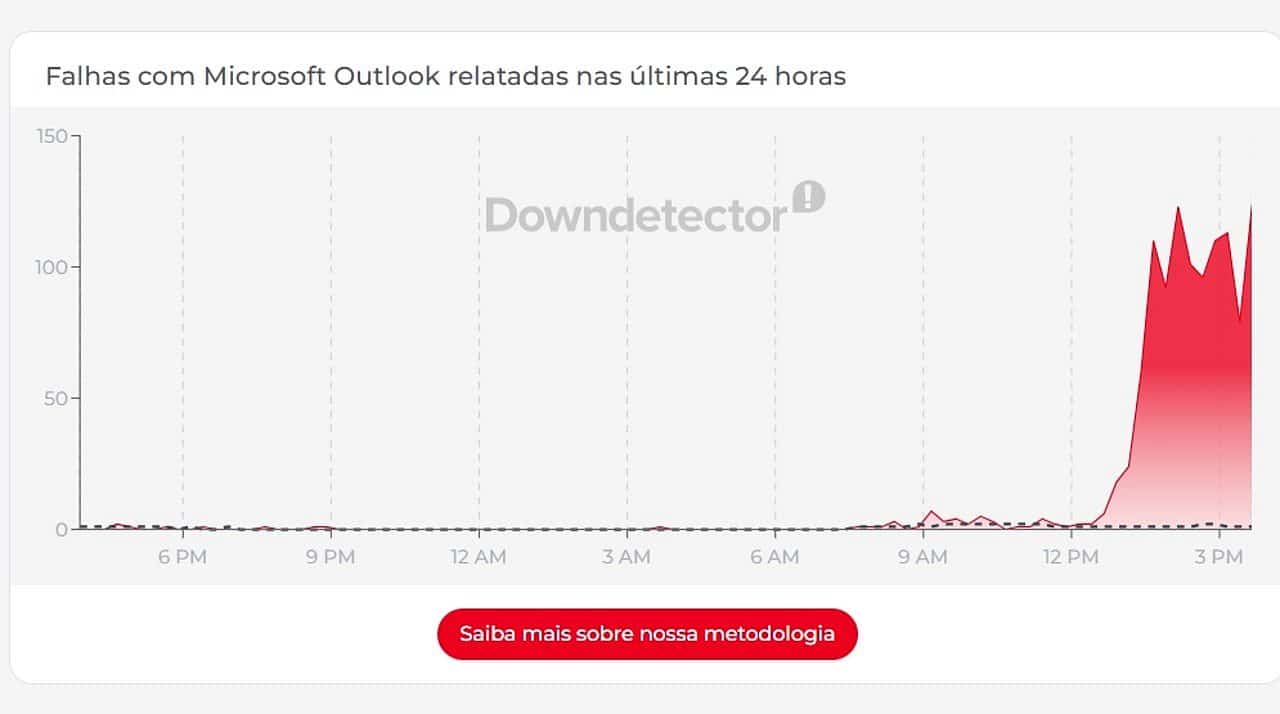
Pierwsze oznaki załamania infrastruktury zaczęły pojawiać się około 8 rano czasu pacyficznego, kiedy mapy monitorujące nagle podskoczyły. Serwis Downdetector, specjalizujący się w sporządzaniu raportów o niestabilności usług cyfrowych, w ciągu pierwszych siedemnastu minut zdarzenia odnotował ponad 6000 powiadomień. Od tego momentu liczba skarg wzrosła wykładniczo, w związku z pojawieniem się różnych stref czasowych w biznesie.
Krótko po godzinie 9 rano zapisy wskazywały już na znaczne pogorszenie stabilności serwerów, przekraczając granicę 13 000 jednoczesnych skarg. Problem narastał szybko przez cały ranek, dotykając całych korporacji. O godzinie 10:35 wspólny panel sterowania pokazał, że 35 000 użytkowników nie ma dostępu, czego kulminacją był alarmujący wzrost liczby prawie 50 000 powiadomień około godziny 11:05.
Co ciekawe, przez większą część tej eskalacji awarii oficjalne narzędzie Microsoftu do sprawdzania kondycji dawało zielone światło dla wszystkich swoich produktów. Panel korporacyjny wskazał, że usługi działają normalnie, w przeciwieństwie do dziesiątek tysięcy biletów otwieranych przez klientów, którzy nie mogli załadować swoich e-maili. Ta tymczasowa rozbieżność opóźniła aktywację protokołów awaryjnych w wielu firmach, które zależą wyłącznie od oficjalnej diagnozy dostawcy.
Źródło problemu technicznego na serwerach Exchange Online
Dochodzenie techniczne wykazało, że przyczyną awarii nie była sama aplikacja pocztowa, lecz infrastruktura zaplecza obsługująca całą operację. Upadek był bezpośrednio powiązany z Microsoft Exchange Online, usługą hostingu w chmurze odpowiedzialną za zarządzanie ruchem, przechowywaniem i dostarczaniem wiadomości. Ponieważ działanie klienta poczty e-mail jest całkowicie zależne od tego szkieletu, wszelkie wąskie gardła na serwerze centralnym powodują wyświetlenie ekranu błędu dla użytkownika końcowego.
Przedstawiciele firmy publicznie potwierdzili rozpoczęcie rygorystycznego dochodzenia w celu wyizolowania winy. W szczegółowym oświadczeniu technicznym opublikowanym w oficjalnych kanałach zespół inżynierów wyjaśnił, że przyczyną incydentu była defekt określonego komponentu uwierzytelniającego. Moduł ten pełni rolę cyfrowego strażnika systemu, odpowiedzialnego za sprawdzanie danych uwierzytelniających każdej osoby próbującej uzyskać dostęp do platformy, zanim umożliwi jej przejrzenie swojej skrzynki odbiorczej.
Aby zachować przejrzystość wobec administratorów sieci, firma skatalogowała kryzys pod kodem identyfikacyjnym EX1464935 w swoim centrum administracyjnym. Niepowodzenie uwierzytelnienia dokładnie wyjaśnia, dlaczego klientom nie udało się przejść przez początkowy ekran ładowania. Kiedy serwer traci możliwość sprawdzenia, kto żąda dostępu, blokuje połączenie ze względów bezpieczeństwa, wyłączając usługę kaskadową dla wszystkich podłączonych terminali.
Główne przeszkody, na jakie napotykają internauci w godzinach porannych
Różnorodność zgłoszonych błędów pokazała, że niestabilność dotknęła wiele warstw ekosystemu komunikacyjnego firmy. Statystyczne badanie skarg pomogło w mapowaniu zachowań awaryjnych różnych urządzeń używanych przez społeczeństwo. Dane skonsolidowane przez platformy monitorujące wykazały następujący rozkład problemów technicznych:
- Największa część dotkniętych problemem, reprezentująca 37% rejestracji, zgłosiła całkowitą blokadę otrzymywania nowych wiadomości, a skrzynki odbiorcze zostały zablokowane bez synchronizacji.
- Około 23% użytkowników spotkało się z bezpośrednimi awariami aplikacji na komputery i telefony komórkowe, uniemożliwiając nawet początkowe otwarcie programu.
- Kolejne 20% wskazało, że portal internetowy był całkowicie niedostępny, wyświetlając komunikaty o błędach serwera przy próbie wczytania strony przez przeglądarkę internetową.
Praktyczny wpływ tego zamknięcia został szeroko udokumentowany na forach dyskusyjnych, takich jak Reddit. Pracownicy wyrażali oburzenie brakiem możliwości wykonywania podstawowych zadań, takich jak wyszukiwanie starych dokumentów, zatwierdzanie umów czy obsługa pilnych klientów. Jeden z najczęściej komentowanych raportów podkreślał frustrację związaną z niemożnością otwarcia strony internetowej, a w rzadkich przypadkach, gdy interfejs był częściowo załadowany, pasek wyszukiwania w dalszym ciągu nie działał.
Korporacyjna zależność od rozwiązań chmurowych i wpływ produkcyjny
Moment, w którym awaria osiągnęła swój szczyt, zbiega się z najbardziej krytycznym okresem dla infrastruktury technologicznej firm: poniedziałkowym rankiem. Ten moment znany jest za kulisami technologii jako burza logowania, kiedy miliony pracowników wracają z weekendu i próbują jednocześnie uzyskać dostęp do swoich systemów. Tak gwałtowny wzrost dostępu wymaga, aby serwery uwierzytelniające działały z maksymalną wydajnością.
Kiedy kluczowy komponent ulegnie awarii dokładnie w tym okresie dużego ruchu, wpływ na ogólną produktywność jest natychmiastowy i poważny. Spotkania są odwoływane ze względu na brak łączy dostępowych, przepływ akceptacji finansowych jest blokowany, a komunikacja zewnętrzna firm jest odcięta. W tym odcinku uwydatniono wyjątkową wrażliwość współczesnych operacji korporacyjnych, które niemal w całości zleciły swoją infrastrukturę komunikacyjną scentralizowanym dostawcom usług w chmurze.
Strategia łagodzenia i testowanie na izolowanej infrastrukturze
Aby zaradzić uszkodzeniom bez ryzyka jeszcze większej przestoju systemu, inżynierowie przyjęli ostrożne podejście do środków zaradczych. Zespół pomocy technicznej opracował strategię naprawczą skupiającą się wyłącznie na naprawie uszkodzonego komponentu uwierzytelniania. Zamiast zastosować aktualizację w całej swojej globalnej sieci jednocześnie, firma zdecydowała się na etapowe wdrażanie, co stanowi rygorystyczną praktykę w zarządzaniu kryzysami technologicznymi na dużą skalę.
Poprawka została początkowo wprowadzona do niewielkiej części infrastruktury serwerowej. To kontrolowane środowisko pozwoliło technikom przetestować skuteczność rozwiązania w czasie rzeczywistym, monitorując, czy poprawka usunie wąskie gardło bez generowania nowych konfliktów w kodzie źródłowym. Oficjalna obietnica była taka, że gdy tylko dyżurni inżynierowie potwierdzą stabilność tej próbki, poprawka zostanie szeroko rozpowszechniona na pozostałych serwerach na całym świecie, normalizując dostęp dla milionów zainteresowanych użytkowników.